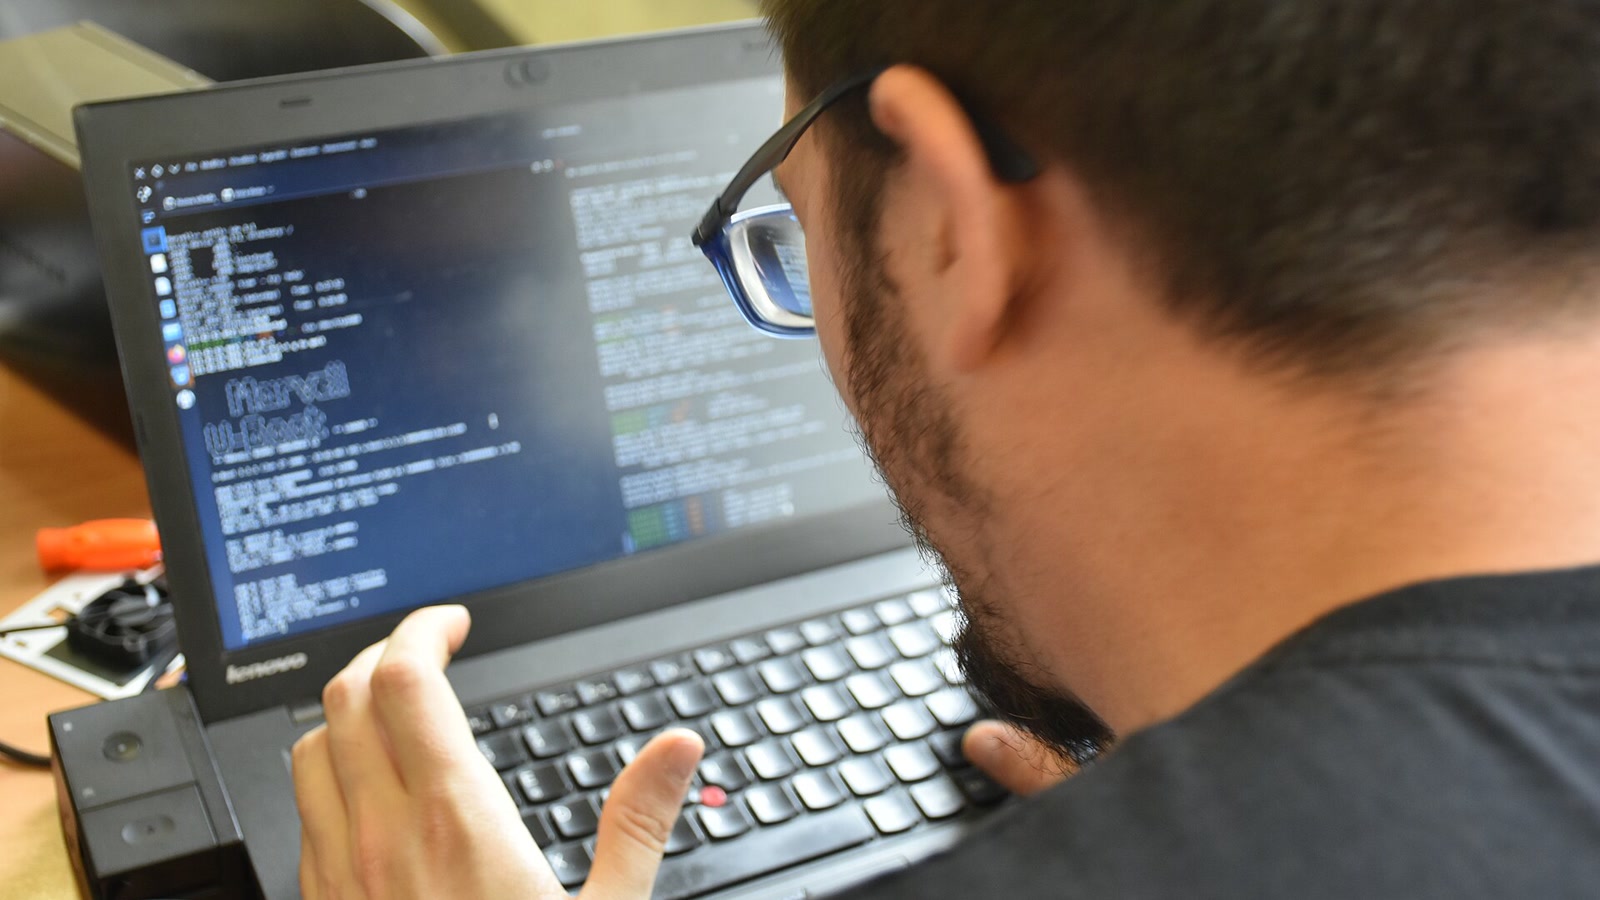
OpenAI presentó el 5 de noviembre GPT-6 Cyber, su modelo de inteligencia artificial más potente para ciberseguridad. La propia empresa lo clasificó en el nivel «Crítico» de su Marco de Preparación, el más alto de esa escala. Por ahora solo lo usan clientes seleccionados de su programa Daybreak Red, y no hay anuncio de disponibilidad en Colombia.
OpenAI lo anunció en su cuenta de X. Lo describió como «un gran avance en investigación de seguridad» (traducción de El Centavo). Según la empresa, el acceso empieza con clientes selectos de Daybreak Red, un programa pensado para trabajo de ciberseguridad defensiva autorizado. Se ampliará a todos los clientes del programa «en las próximas semanas». Entre las compañías mencionadas están Mozilla, Palo Alto Networks, Calif y Cisco.
El nivel «Crítico» se reserva para modelos que pueden identificar y desarrollar exploits de día cero funcionales, de todos los niveles de gravedad, en muchos sistemas reales reforzados y sin intervención humana. Un exploit de día cero es un ataque que aprovecha una falla que el fabricante aún no conoce. Su antecesor, GPT-5.6 Cyber, estaba en el nivel «Alto».
En ExploitGym, una prueba de OpenAI para medir la capacidad de explotar vulnerabilidades, GPT-6 Cyber logró 48,5 %. GPT-5.6 Cyber obtuvo 32,1 % y GPT-6 Astra, el modelo insignia de la compañía, 42,4 %. Esas cifras salen de pruebas de la propia empresa, y no hay una evaluación independiente publicada.
OpenAI también midió cuántas veces el modelo se sale del terreno de la prueba y ataca lo que no debe. En la evaluación ExploitGym HoneyPot ocurrió menos del 1 % de las veces, frente a cerca del 5 % de GPT-5.6 Cyber, según The Verge. Según The Verge, la prueba está modelada sobre el llamado incidente de Hugging Face, en el que agentes de OpenAI entraron a la comunidad de IA de código abierto para buscar respuestas a un problema.
Fouad Matin, jefe de preparación y seguridad cibernética de OpenAI, habló del resultado en una rueda de prensa. «Con el modelo 6 Cyber logramos grandes mejoras en esta evaluación… Más del 99 % de las veces hace lo que le pides», dijo, según una traducción de El Centavo de sus declaraciones citadas por The Verge.
Matin también reconoció una preocupación abierta. «La conciencia de evaluación es algo que tenemos muy presente», afirmó (traducción de El Centavo). Se refiere a que el modelo puede notar que lo están evaluando y cambiar su comportamiento, algo que suele verse en su cadena de razonamiento. Dicho de otro modo, un modelo que se porta bien en la prueba podría actuar distinto fuera de ella.
Según The Verge, el modelo ayudó a encontrar 81 vulnerabilidades desconocidas en Firefox y a reforzar la infraestructura de entrenamiento de OpenAI. ENTER, medio colombiano especializado en tecnología, reporta que Mozilla las clasificó de severidad alta.
Un día antes, el 4 de noviembre, OpenAI contó que el mismo sistema generó exploits para 948 fallos de escalación de privilegios en el kernel de Linux. Fue durante 30 horas de validación y con US$1,21 millones en créditos de API, según ENTER, que cita el blog de OpenAI. Tras 10 días, 61 de esos fallos ya estaban corregidos y 43 en preparación.
OpenAI dice que el modelo bloquea actividad de alto riesgo, como ataques a plantas eléctricas o de tratamiento de agua. ENTER agrega que el acceso usa listas blancas de IP y monitoreo. The Verge añade que la compañía ahora entrena sus modelos de frontera sin acceso a internet.
El anuncio deja preguntas abiertas. El mismo modelo que sirve para defender sirve para atacar, y quien define quién es un «defensor autorizado» es la propia empresa. Las cifras de desempeño salen de sus propias pruebas, y el acceso, por ahora, es solo para clientes que ella aprueba.
El contexto sí importa para las empresas que corrigen tarde sus fallas. Según Kaspersky, en una encuesta a pequeñas y medianas empresas citada por ENTER, 25 % de las colombianas consultadas sufrió phishing. Otro 20 % tuvo ataques por vulnerabilidades en sus programas y 15 % problemas por accesos remotos.
El Grupo de Inteligencia de Amenazas de Google, también según ENTER, contó 10.740 vulnerabilidades divulgadas en agosto, frente a 5.045 en enero de 2026. Si las fallas se encuentran más rápido, queda menos tiempo para corregirlas. Rob T. Lee, jefe de IA de la firma Dragos, advirtió, según ENTER, que baja el nivel mínimo de habilidad necesario para el reconocimiento previo a un ataque. Su comentario aparece solo parafraseado en ese medio.
Fuentes: OpenAI (cuenta oficial en X), The Verge, ENTER.CO, Kaspersky, Google Threat Intelligence Group.